Teste no Campfire: fila maior melhora entrega e eleva atraso máximo a mais de dois minutos
Entregar mais notificações pode significar deixar algumas esperando por mais de dois minutos. Reaproveitar um plano de consulta pode economizar planejamento e aumentar o trabalho do banco em cada execução. Dois experimentos abrem esta segunda-feira com exemplos desses custos — e das medições necessárias para percebê-los. A edição também traz HTTPS para servidores privados, atualizações de Linux e ferramentas de desenvolvimento.
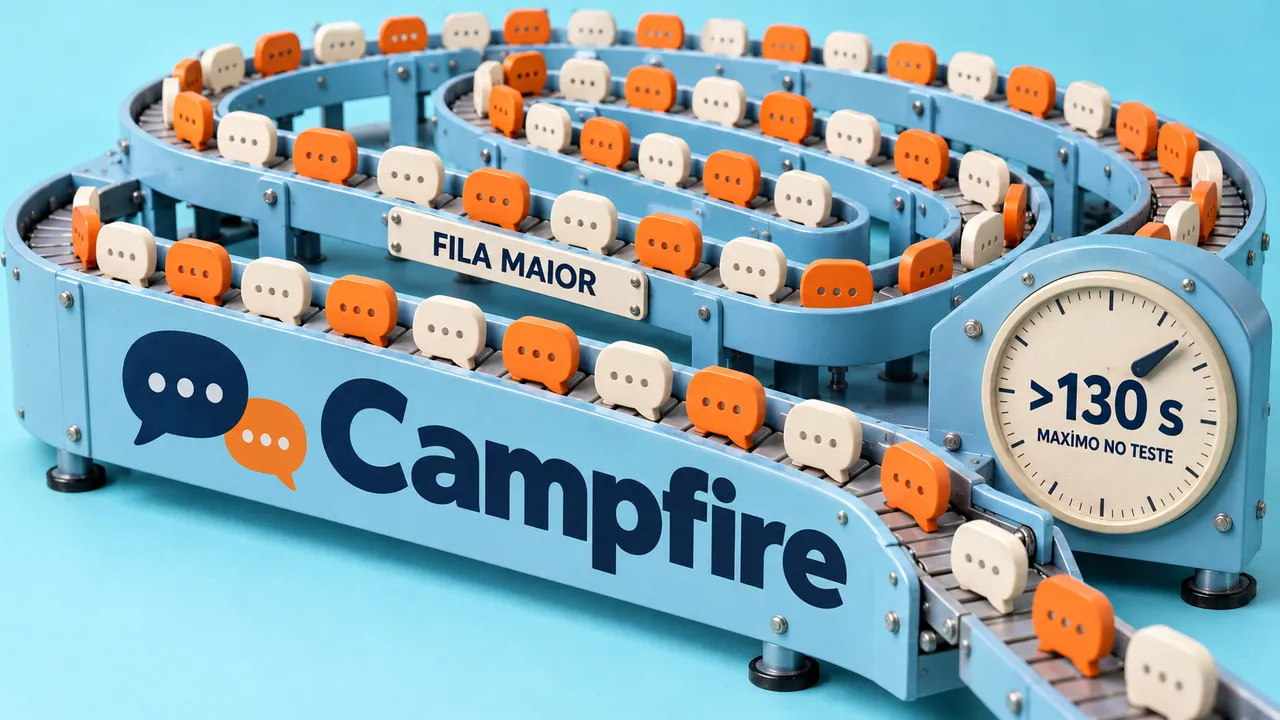
Campfire: fila maior entrega mais notificações, com atraso máximo acima de 130 segundos
Piotr Sarnacki publicou em 11 de outubro testes das reescritas do Campfire, uma aplicação de chat. Ele enviou requisições a uma taxa constante, independentemente da velocidade das respostas. Assim, o teste mantém a chegada de trabalho mesmo quando o servidor começa a demorar para responder.
Na implementação Rust examinada, aumentar a capacidade da fila de 256 para 16.384 eventos elevou a proporção de notificações recebidas de aproximadamente 14% para 90%, sob carga de 100 requisições por segundo. O maior atraso de entrega, porém, passou de 11 segundos para mais de 130 segundos. Os números são do experimento de Sarnacki, com aquelas implementações e condições de carga.
Essa fila distribui eventos, como o aviso de que há uma nova mensagem no chat. Ela usa um canal do Tokio, biblioteca de execução assíncrona em Rust. Quando um consumidor fica para trás e eventos antigos são sobrescritos, o canal sinaliza a perda; a aplicação decide como reagir. Na versão examinada, clientes atrasados são desconectados. Segundo Sarnacki, o navegador busca as mensagens atuais ao reconectar: uma notificação perdida pode ser compensada por essa nova consulta.
A medição útil reúne entrega, atraso e recuperação após a reconexão. O limite de memória da fila e a reação a clientes lentos também fazem parte da decisão. Nesse teste, ampliar a capacidade permitiu entregar mais avisos, ao custo de manter alguns deles esperando por muito mais tempo.
Fontes: experimento de Sarnacki e comportamento do canal broadcast do Tokio.
PostgreSQL: forçar plano genérico reduz vazão em teste com mil partições
Antes de executar uma consulta, o PostgreSQL prepara um plano de execução. Em consultas preparadas com parâmetros, o banco pode gerar um plano personalizado para os valores recebidos ou usar um plano genérico, reaproveitado com valores diferentes. O parâmetro plan_cache_mode controla essa escolha; no padrão, auto, o banco compara estimativas de custo levando em conta o trabalho de planejar novamente.
Christophe Pettus mostrou, em 11 de outubro, como a economia de planejamento pode vir acompanhada de execução mais cara. Seu teste usou PostgreSQL 18.6, dois clientes do pgbench, consultas preparadas e uma busca por transação em uma tabela dividida em mil partições. Ao trocar auto pelo plano genérico forçado, a vazão caiu de cerca de 50 mil para 2.600 transações por segundo. Segundo o autor, o plano genérico adquiria bloqueios em todas as partições antes de descartar as desnecessárias durante a execução.
O resultado muda com a carga: no teste com apenas oito partições, o plano genérico foi mais rápido. Forçar planos personalizados também tem custo, pois repete o planejamento, inclusive em operações internas que usam o cache de planos, como certas verificações de chaves estrangeiras.
Pettus recomenda manter auto na configuração geral e medir exceções no menor escopo possível. Para investigar uma consulta preparada, EXPLAIN EXECUTE mostra o plano utilizado. Ao reproduzir o teste, preserve também a forma como o driver envia as consultas e agrupa as transações: essas condições influenciam o reaproveitamento e a duração dos bloqueios.
Fontes: medições e orientações de Pettus e documentação de PREPARE no PostgreSQL 18.
DNS-01 permite emitir certificados para serviços acessíveis só pela rede local
Carlos Asmat publicou em 11 de outubro seu caminho para colocar HTTPS no servidor doméstico usando Caddy, um servidor web que automatiza certificados. A peça central é o desafio DNS-01 do Let’s Encrypt: a autoridade certificadora consulta um registro TXT no DNS público para confirmar o controle do nome de domínio. Como a verificação acontece pelo DNS, o servidor da aplicação pode continuar acessível apenas pela rede local ou por uma VPN.
O certificado é emitido para um nome de domínio usado pelo serviço privado. O DNS-01 não valida um endereço IP. Essa distinção importa ao planejar o acesso ao servidor e a emissão do certificado.
Como a integração de seu provedor de DNS com Caddy deixou de compilar, Asmat delegou a validação para outra zona de DNS, hospedada no deSEC. A documentação do Let’s Encrypt confirma o uso de registros CNAME ou NS para encaminhar essa validação a outra zona. Isso permite separar o provedor que atende o domínio daquele usado para automatizar a emissão.
Proteja a credencial da API de DNS: quem a obtém pode ganhar capacidade de emitir certificados dentro do seu escopo. Prefira permissões restritas, proteja a interface administrativa do Caddy e teste a renovação. O certificado comprova o controle do nome; a restrição de acesso ao serviço continua dependendo da rede e do firewall.
Fontes: relato de Asmat e desafios e cuidados do Let’s Encrypt.
Destaques rápidos para hoje.
-
Qwen em GPU AMD: autor relata 105 a 160 tokens por segundo, com avaliação de qualidade limitada. Em relato de 11 de outubro, t0mj descreve executar Qwen3.8-Flash-Next com Strata em uma Radeon 7900 XTX, distribuindo os pesos do modelo entre a memória da GPU e a RAM do computador. Ele configurou cerca de 500 mil tokens de contexto. A avaliação de qualidade usou 16 itens, duas repetições e chegou a 256 mil tokens, apenas com texto e sem medir chamadas de ferramentas. Para quem pretende reproduzir o experimento, a janela configurada e a velocidade de geração precisam ser avaliadas junto com os acertos nas tarefas de interesse. Fonte: configuração, resultados e limitações do experimento.
-
drgn 0.3.0 reforça a leitura de arquivos de depuração não confiáveis. Lançado em 10 de outubro, o depurador programável corrige falhas de segurança de memória e limita recursão excessiva ao processar informações de depuração e arquivos com o estado de um processo após uma falha, os core dumps. As notas dizem que parte dos problemas pode ser acionada por entradas especialmente preparadas. A versão também permite ler a memória de máquinas virtuais diretamente do processo QEMU, quando possível. Quem analisa dumps recebidos de terceiros tem um motivo concreto para avaliar a atualização. Fonte: notas oficiais do drgn 0.3.0.
-
Funções para Zsh anunciam hooks executáveis do Git ao entrar no projeto. Ned Batchelder publicou em 11 de outubro uma forma de exibir os nomes desses scripts, que rodam em determinadas operações do Git. O cuidado é especialmente útil ao receber uma cópia completa de um checkout, incluindo sua pasta
.git: ela pode trazer hooks já instalados. Umgit clonecomum não copia os hooks locais do repositório de origem. O aviso ajuda na inspeção; ele não bloqueia a execução dos scripts. Fontes: implementação de Batchelder e manual de hooks do Git. -
Testar o README com usuários revelou links errados e instruções ambíguas. Terence Eden contou em 11 de outubro que pagou cerca de €150 por sessões em que pessoas tentavam instalar o ActivityBot seguindo a documentação. Elas compartilhavam a tela e explicavam em voz alta o que estavam tentando fazer. Surgiram problemas com arquivos ocultos, terminologia, ordem das seções e até com a explicação do propósito do programa. Ele corrigia o documento após cada sessão e testava novamente com outra pessoa. A prática ajuda a encontrar passos que o autor preenche de memória ao seguir as próprias instruções. Fonte: relato dos testes de Eden.
-
zt transforma templates HTML em código Zig verificado pelo compilador. Apresentado por Lukáš Lalinský em 11 de outubro, o projeto gera código durante
zig build, permitindo conferir tipos dos parâmetros e detectar referências a campos inexistentes. Valores dinâmicos recebem escape HTML por padrão, para serem tratados como texto; atributos de URL também passam por verificação de esquemas perigosos. Esses cuidados reduzem fontes comuns de injeção de conteúdo. A ferramenta permite inserir HTML bruto explicitamente, portanto esse caminho exige cuidado próprio. O autor avisa que o projeto ainda é jovem e que parte da sintaxe está em discussão. Fonte: apresentação do zt. -
Decision 3.0 oferece probabilidades para escolhas com texto, imagens e vídeos. O modelo d3, da equipe vLLM Semantic Router, tem pesos disponíveis sob Apache-2.0 e responde a alternativas, perguntas de sim ou não e escalas, sem gerar uma resposta em prosa. Isso permite experimentar classificação e encaminhamento de pedidos entre ferramentas. A integração nativa está no canal de desenvolvimento do Semantic Router. Antes de automatizar decisões, teste os acertos nos seus próprios exemplos e confira se as probabilidades informadas correspondem à frequência de acertos observada. Fonte: model card do d3 e condições de uso.
-
Linux chega ao 7.3-rc7, enquanto as linhas estáveis recebem 7.2.10 e 6.18.56. O kernel.org registra a nova candidata a lançamento em 12 de outubro e as duas atualizações estáveis em 11 de outubro. São canais com finalidades diferentes: a candidata atende aos testes da próxima versão; para máquinas de trabalho, acompanhe os pacotes e orientações de atualização da sua distribuição. Fonte: versões publicadas no kernel.org.
Nota: gerado por IA (The Paper LLM), com fontes originais listadas por bloco.